Un enseignant reçoit un devoir dont le style lui semble trop lisse. Il colle le texte dans un outil en ligne, obtient un score de 92 % de probabilité de génération par IA, et envisage une sanction.
Dans une étude publiée en 2023 dans la revue Patterns (Liang et al.), sept détecteurs ont classé à tort comme générés par IA en moyenne 61,22 % des essais rédigés par des apprenants non natifs de l’anglais, contre 5,19 % pour des textes d’élèves américains. Un score ne constitue pas une preuve d’origine d’un texte, et les conséquences d’une erreur de classification peuvent être lourdes.
Faux positifs et biais linguistiques des détecteurs de texte IA
On parle rarement du profil des personnes les plus exposées aux erreurs de détection. Les chiffres de l’étude Liang et al. montrent un écart massif : un rédacteur dont le français ou l’anglais n’est pas la langue maternelle produit souvent des phrases plus courtes, un vocabulaire plus restreint et des structures répétitives. Ce sont précisément les signaux que les détecteurs associent à une génération automatique.
En pratique, cela signifie qu’un étudiant étranger, un collaborateur multilingue ou un journaliste écrivant dans une langue seconde risque davantage d’être faussement accusé. Avant de tirer des conclusions d’un résultat affiché par un détecteur ia comme ZeroGPT ou tout autre outil, on doit prendre en compte le contexte linguistique du rédacteur.
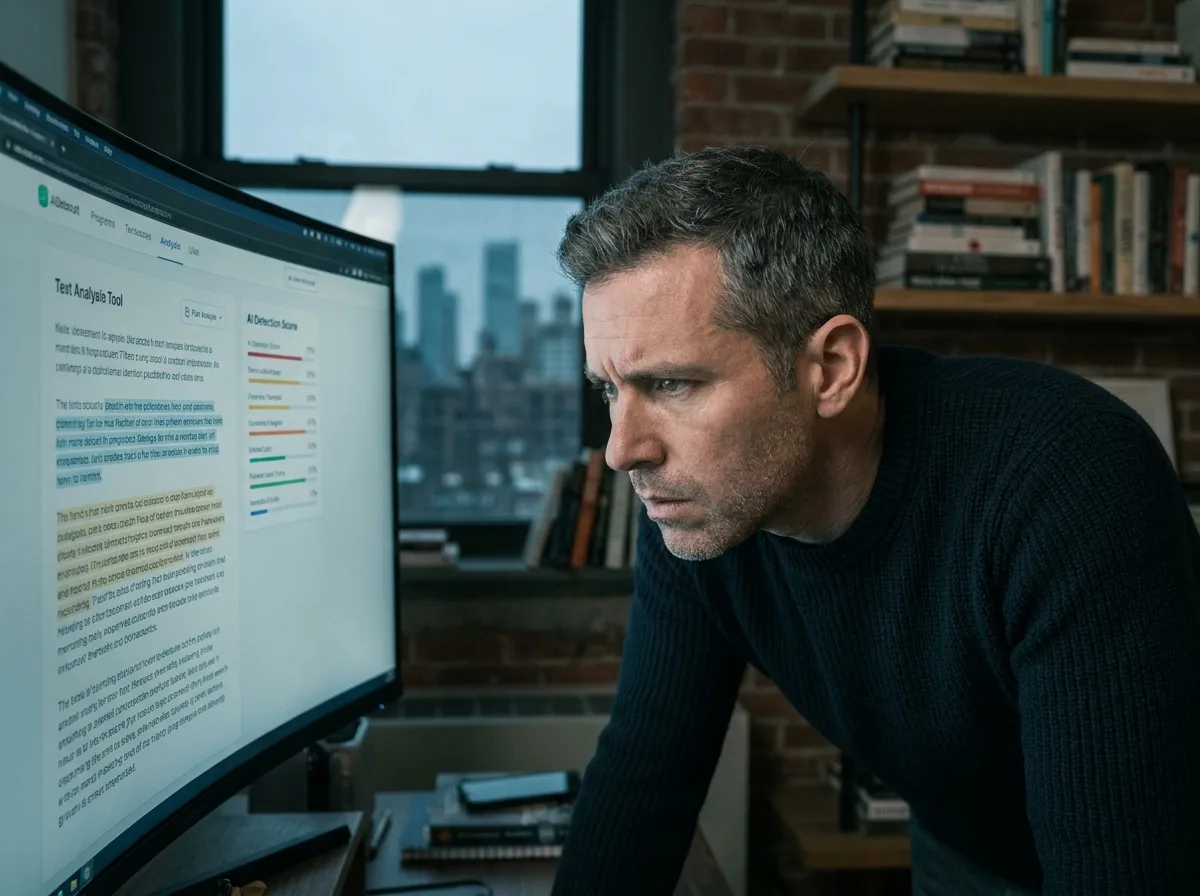
ZeroGPT propose une interface simple : on colle un texte, l’outil renvoie un pourcentage estimé de contenu généré par IA et surligne les passages suspects. Cette granularité, passage par passage, aide à cibler la discussion sur des extraits précis plutôt que de rejeter un document entier sur la base d’un chiffre global.
Perplexité, seuils de confiance et fiabilité des outils de détection
Les détecteurs de contenu IA fonctionnent principalement en mesurant deux indicateurs statistiques : la perplexité (à quel point le mot suivant est prévisible pour un modèle de langage) et la variabilité (l’écart de registre et de longueur entre les phrases). Un texte très prévisible obtient une perplexité basse, ce qui pousse l’outil à le classer comme généré par IA.
Le résultat dépend directement du seuil choisi par l’outil. Un seuil bas augmente la détection des textes IA, mais augmente les faux positifs. Un seuil élevé réduit les fausses accusations, au prix de davantage de textes IA non repérés. Selon une étude publiée dans les actes de l’ACM en 2026, un bon score de classement global ne garantit pas un faible taux de fausses accusations au seuil effectivement utilisé.
En clair, deux outils peuvent afficher des résultats contradictoires sur le même texte, simplement parce qu’ils n’appliquent pas le même seuil de confiance. Comparer les scores de plusieurs détecteurs sans connaître leurs paramètres internes ne produit aucune certitude exploitable.
Quand une simple reformulation change le score
La même étude ACM 2026 documente un point opérationnel que les utilisateurs sous-estiment : une modification légère peut suffire à inverser le verdict d’un détecteur. Corriger une faute, reformuler une phrase, traduire un paragraphe, tout cela altère les signaux statistiques sur lesquels repose l’analyse.
Un texte rédigé par un humain puis relu par un correcteur automatique peut voir son score de détection IA augmenter. À l’inverse, un texte entièrement généré par ChatGPT puis retouché manuellement peut passer sous le radar. Le score mesure un profil statistique à un instant donné, pas l’intention de l’auteur.
Procédure contradictoire avant sanction : ce que les institutions doivent mettre en place
Utiliser un outil de détection comme élément d’alerte est une chose. Fonder une sanction académique ou professionnelle sur un score seul en est une autre. On peut structurer une procédure en plusieurs étapes pour limiter les erreurs :
- Soumettre le texte à au moins deux outils de détection indépendants (ZeroGPT, Quillbot, Originality.ai) et comparer les résultats passage par passage, pas seulement le score global
- Confronter le rédacteur au résultat et lui donner la possibilité de fournir ses brouillons, son historique de recherche ou ses notes préparatoires
- Faire relire le texte par un évaluateur humain qui vérifie la cohérence des arguments, la pertinence des exemples et la maîtrise du sujet, indépendamment du score
- Documenter la décision avec les scores obtenus, les éléments contradictoires examinés et la justification finale
Cette approche contradictoire n’est pas un luxe administratif. Elle protège l’institution autant que la personne évaluée. Un étudiant sanctionné à tort sur la base d’un faux positif peut contester la décision, et l’établissement se retrouve sans base solide si aucune procédure vérifiable n’a été suivie.
Signaux de provenance et watermarking : pistes complémentaires à l’analyse stylistique
L’analyse stylistique n’est pas la seule approche. OpenAI a développé des signaux de provenance intégrés aux contenus générés par ses modèles : des métadonnées associées aux fichiers produits qui permettent, en théorie, de remonter à l’outil d’origine.
Ces signaux ne sont ni universels ni infaillibles. OpenAI précise que des transformations (copier-coller, conversion de format, traduction) peuvent faire disparaître les informations de provenance. Un signal de provenance ne prouve pas non plus l’exactitude du contenu ni son contexte d’utilisation.
Le watermarking statistique, qui consiste à biaiser légèrement le choix des mots lors de la génération pour y intégrer une signature détectable, reste expérimental à grande échelle. Il pose des questions de compatibilité entre modèles et de robustesse face aux reformulations.
Ce que ces outils ne remplaceront pas
Ni les détecteurs stylistiques, ni les signaux de provenance ne répondent à la question de fond : le texte apporte-t-il une réflexion originale, des arguments solides, une connaissance réelle du sujet ? Un texte entièrement humain peut être creux, et un texte assisté par IA peut contenir un travail de fond sérieux.
Les outils de détection de texte généré par IA restent des indicateurs statistiques, utiles comme premier filtre mais insuffisants comme preuve. Les institutions qui les intègrent à leurs processus d’évaluation gagneront en crédibilité en publiant leurs critères de décision, leurs seuils d’alerte et les droits de réponse qu’elles accordent aux personnes concernées.